ChemDFM 系列来自上海交通大学与苏州实验室等团队, 目标是让同一个模型理解化学知识、处理多种任务, 并通过对话参与科研.
| 工作 | 主要问题 | 模型基础 |
|---|---|---|
| ChemDFM | 通用 LLM 认识化学名词, 却不熟悉分子表示与化学任务 | LLaMA-13B |
| ChemDFM-X | 实验信息还存在于图、三维结构、图片和光谱中 | 冻结的 ChemDFM-13B |
| ChemDFM-R | 会输出化学答案, 仍可能缺少有依据的中间推理 | Qwen2.5-14B |
这里的 X 和 R 是两条能力扩展路线. X 直接接在 ChemDFM 上; R 则更换为 Qwen2.5-14B 基座, 并没有在 X 的多模态架构上继续训练.
ChemDFM
[] Unknown-material 关注一个很实际的问题: 单任务模型通常需要固定输入和专门训练, 化学研究者却会不断切换任务, 追问解释, 修改条件. 作者希望保留通用语言模型的对话能力, 同时补上它对化学知识和分子表示的理解.
两阶段训练
对 LLM 而言, 化学必须把一段字符串对应到具体分子的结构, 再联系到性质和反应. ChemDFM 选择 SMILES 作为主要分子表示, 因为它既能编码结构, 又可以直接进入文本模型.
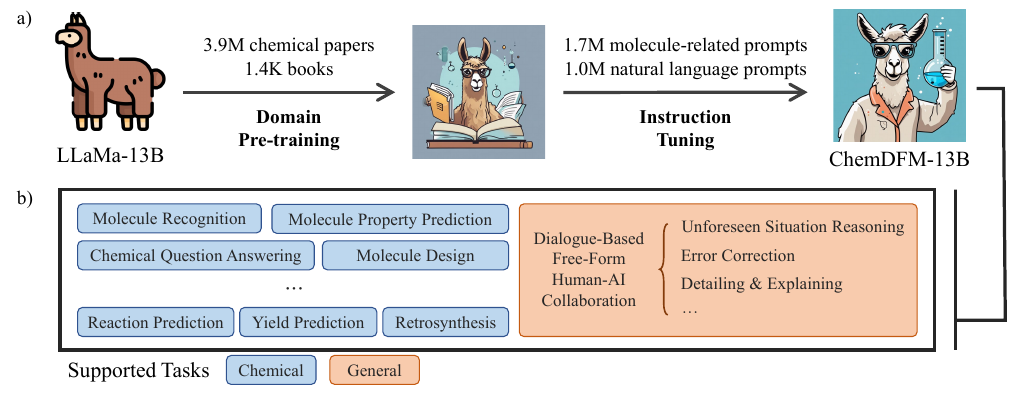
第一阶段是领域预训练. 以 LLaMA-13B 为起点, 继续学习约 34B token 的化学文献以及约 1,400 本教材. 正文 §2.1 给出的文献规模约为 390 万篇, 时间截止到 2022 年 1 月前; 教材提供基础原则, 论文提供更细的研究知识. 训练还混入百科、代码等通用语料, 保留语言能力.
第二阶段是指令微调. 作者将约 270 万条领域相关指令整理成统一对话格式, 让模型学会按要求调用知识. 原论文 Table 1 的主要组成如下:
| 指令类型 | 样本量 | 希望学到什么 |
|---|---|---|
| 数据集问答与考试问答 | 131K + 915K | 理解问题, 回答科学知识与化学题目 |
| Molecule Description | 576K | 从 SMILES 生成分子描述 |
| Text-Based Molecule Design | 576K | 从文字描述生成相应分子的 SMILES |
| Molecular Property Prediction | 102K | 将结构与性质标签联系起来 |
| Reaction Completion | 300K | 补全被遮住的反应物、试剂或产物 |
| Molecular Notation Alignment | 120K | 在 SMILES、IUPAC 名称和分子式间转换 |
分子描述及其反向任务主要来自 PubChem, 性质预测来自 MoleculeNet, 反应补全来自 USPTO 专利反应数据库. 每个任务的指令又被改写成 20–200 种表达, 避免模型只认识固定模板. 此外, 化学数据与通用指令按约 $1:2$ 混合进行全参数微调; 表中的约 270 万条不能直接当作混合后全部训练样本数.
这套方法最有启发性的地方是 双向连接自然语言与分子表示: 一边做“分子 → 描述”, 一边做“描述 → 分子”, 再加入性质和反应任务. 模型需要在这些任务之间共享化学知识.
实验说明了什么
主要评测来自 ChemLLMBench , 涵盖分子识别、文字条件分子设计、性质预测和反应分析. 论文的标准设置对不少任务抽取 100 个测试样本, 部分任务另有完整测试集评估, 读数字时需要区分.
对于我关心的 文字条件分子生成, 更值得看附录 Table 7 的完整 ChEBI-20 测试集:
| 模型 | Exact Match (%) | SMILES 有效率 (%) | Morgan 指纹相似度 |
|---|---|---|---|
| MolXPT | 21.5 | 98.3 | 0.667 |
| Text+Chem T5 | 32.2 | 94.3 | 0.757 |
| ChemDFM-13B | 43.2 | 97.6 | 0.759 |
这说明模型学到了较好的“描述—结构”对应关系. 但该任务要求恢复与文字描述对应的参考分子, 没有直接验证新分子的合成可行性、目标性质改善或跨化学空间迁移.
优势也不均匀: 五个性质分类任务的平均 AUC-ROC 为 77.7, 高于当时比较的通用 LLM, 仍低于 Uni-Mol 的 82.2 和 MolXPT 的 83.8; 逆合成与命名转换同样保留了明显提升空间. 因而这篇的主要价值是把多种化学任务和自由对话整合进同一个模型.
ChemDFM-X
[] Unknown-material 考虑的是已经能读 SMILES 的模型, 能否进一步直接读取研究者手里的结构图和实验表征, 也就是说其引入了几个新模态.
结构信息与表征信息
论文在文本、SMILES 之外新增五类输入: 二维分子图、三维构象、分子/反应图片、串联质谱 MS2、红外光谱 IR.
几个模态的含义
- 二维分子图用节点表示原子、边表示化学键.
- 三维构象进一步给出原子空间坐标, 同一连接结构可以有不同构象.
- MS2 (MS/MS, 串联质谱) 通常选取前体离子, 使其碎裂, 再测量碎片离子的质荷比 $m/z$ 与相对强度. 峰的位置和组合提供分子组成、片段与连接方式的线索.
- IR (红外光谱) 反映分子振动对红外光的吸收, 常以波数 $\mathrm{cm^{-1}}$ 为横轴. 不同化学键和官能团有不同吸收特征, 但单条谱线通常不能唯一确定完整结构.
多个编码头联合
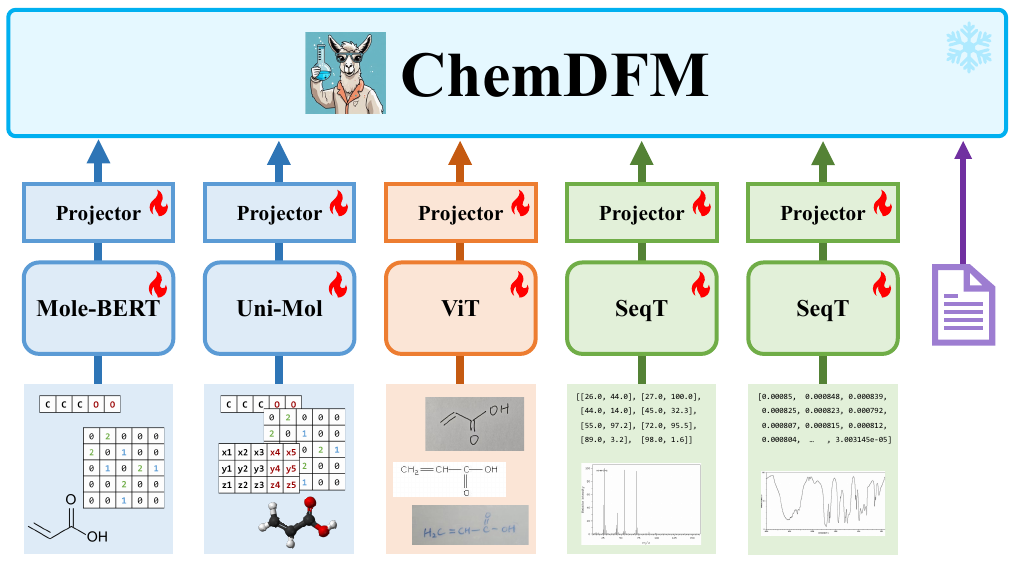
每种模态先经专用编码器提取特征, 再投影到 ChemDFM 的输入嵌入空间. 可以将这一接口写成
$$ \mathbf Z_m=P_m(E_m(x_m)),\qquad p(y\mid q,\{x_m\})=\prod_t p_\theta(y_t\mid q,\{\mathbf Z_m\},y_{\lt t}). $$其中 $m$ 表示模态, $E_m$ 为编码器, $P_m$ 为投影模块, $q$ 为文字指令. 输出仍由语言模型生成, 包括文字和 SMILES.
训练时 冻结 ChemDFM, 更新模态编码器与投影模块. 这样可以保留已有的语言和 SMILES 能力, 让新增模块学习如何把信息送进这个接口. 图片分支另设 H-Reducer, 因为直接缩小复杂反应图会丢失键、原子标签等细节.
数据构造
化学多模态数据的困难在于配对成本, 尤其是像 MS2 和 IR 这类光谱数据获取成本较高. 作者以种子 SMILES 为出发点, 构造跨模态指令数据:
- 二维图由 SMILES 解析得到.
- 三维构象先用 RDKit 生成, 再用 MMFF 分子力场 优化, 得到近似构象.
- 图片由 RDKit、Indigo 和伪手写图生成流程产生, 并加入颜色等增强.
- MS2通过 CFM-ID 4.0 预测; 约 70 万条模拟谱用于相关谱编码器训练数据构造.
- IR通过 Chemprop-IR 预测; 相应光谱规模约为 100 万条.
实验结果
论文的结构任务显示, 多一个模态未必显著提高性质预测. 不过值得一提的是 反应上下文与光谱的互补. 原论文 Table 11 中, 单靠 MS2 或 IR 识别分子的 Top-1 准确率分别只有 0% 和 1%; 给出反应的已知部分后, 再加入未知物质的 IR 谱, 两项任务分别达到 64% 和 60%.
ChemDFM-R
[] Unknown-material 认为, 从结构直接预测性质或反应结果, 缺少了化学家经常使用的一层中间知识, 即分子中的官能团, 以及由此带来的可能反应位置和反应前后局部结构变化.
ChemFG 训练集
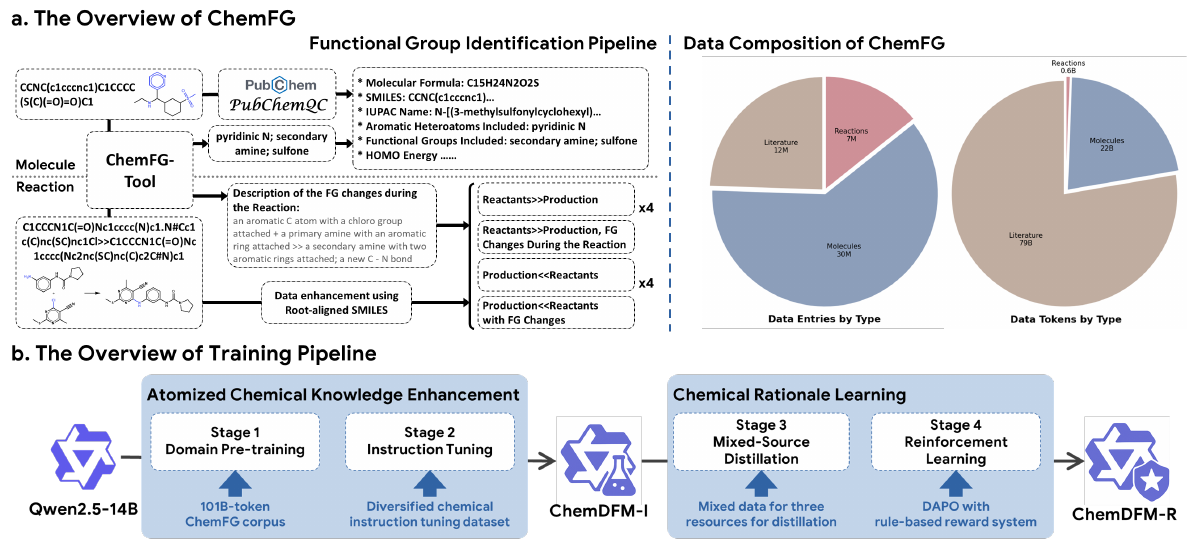
作者在 thermo 的子结构匹配工具上构建 ChemFG-Tool, 将可识别官能团从 83 类扩展到 241 类, 并处理重叠和复合官能团. 对分子, 工具输出官能团类别及其位置; 对反应, 先利用 atom mapping 对齐反应前后的原子, 找出发生键变化的反应中心, 再标注与中心相关的官能团变化. 环的形成、断裂及官能团之外的键变化也单独记录.最终 ChemFG 包含约 101B token, 来源包括约 1,200 万篇文献、3,000 万个分子和 700 万条反应记录.
四阶段训练
- 领域预训练. 从 Qwen2.5-14B 出发, 在 ChemFG 上做 next-token prediction, 同时混入通用语料. 让模型先学会分子、官能团、性质和反应之间的对应关系.
- 指令微调. 整合命名转换、文献问答、性质排序、反应补全等 16 类任务, 并丰富指令表达. 得到中间模型 ChemDFM-I.
- 混合来源蒸馏. 直接向通用推理模型索要化学 CoT 并不可靠, 因为教师也可能错误识别官能团, 再围绕错误结构写出流畅解释. 作者将化学部分的训练数据分为原指令微调数据、伪推理数据和教师推理链三组. 构造教师推理链时, 教师接收到问题、标准答案和官能团信息, 然后据此再生成解释. 这让教师将精力放在串联已知化学事实, 降低从错误结构出发推理的概率.
- 强化学习. 从可验证答案的任务中构造训练样本, 使用 DAPO 优化模型. 奖励由格式和答案正确性组成.
参考文献
- Xia, J., Zhao, C., Hu, B., Gao, Z., Tan, C., Liu, Y., Li, S., and Li, S. Z. Mole-BERT: Rethinking Pre-Training Graph Neural Networks for Molecules. International Conference on Learning Representations, 2023.
- Zhou, G., Gao, Z., Ding, Q., Zheng, H., Xu, H., Wei, Z., Zhang, L., and Ke, G. Uni-Mol: A Universal 3D Molecular Representation Learning Framework. International Conference on Learning Representations, 2023.
- Wang, F., Liigand, J., Tian, S., Arndt, D., Greiner, R., and Wishart, D. S. CFM-ID 4.0: More Accurate ESI-MS/MS Spectral Prediction and Compound Identification. Analytical Chemistry, 93(34):11692–11700, 2021.
- McGill, C., Forsuelo, M., Guan, Y., and Green, W. H. Predicting Infrared Spectra with Message Passing Neural Networks. Journal of Chemical Information and Modeling, 61(6):2594–2609, 2021.
- Hu, A., Xu, H., Ye, J., Yan, M., Zhang, L., Zhang, B., Li, C., Zhang, J., Jin, Q., Huang, F., et al. mPLUG-DocOwl 1.5: Unified Structure Learning for OCR-free Document Understanding. arXiv:2403.12895, 2024.
- Guo, T., Guo, K., Nan, B., Liang, Z., Guo, Z., Chawla, N. V., Wiest, O., and Zhang, X. What Can Large Language Models Do in Chemistry? A Comprehensive Benchmark on Eight Tasks. Advances in Neural Information Processing Systems, Datasets and Benchmarks Track, 2023.
- Yu, Q., Zhang, Z., Zhu, R., Yuan, Y., Zuo, X., Yue, Y., Dai, W., Fan, T., Liu, G., Liu, L., et al. DAPO: An Open-Source LLM Reinforcement Learning System at Scale. arXiv:2503.14476, 2025.
- Feng, K., Ding, K., Wang, W., Zhuang, X., Wang, Z., Qin, M., Zhao, Y., Yao, J., Zhang, Q., and Chen, H. SciKnowEval: Evaluating Multi-Level Scientific Knowledge of Large Language Models. arXiv:2406.09098, 2024.
- Huang, Y., Zhang, R., He, X., Zhi, X., Wang, H., Li, X., Xu, F., Liu, D., Liang, H., Li, Y., et al. ChemEval: A Comprehensive Multi-Level Chemical Evaluation for Large Language Models. arXiv:2409.13989, 2024.
- Liu, Z., Zhang, W., Xia, Y., Wu, L., Xie, S., Qin, T., Zhang, M., and Liu, T.-Y. MolXPT: Wrapping Molecules with Text for Generative Pre-training. Proceedings of ACL, Volume 2: Short Papers, pp. 1606–1616, 2023.
- Christofidellis, D., Giannone, G., Born, J., Winther, O., Laino, T., and Manica, M. Unifying Molecular and Textual Representations via Multi-task Language Modelling. International Conference on Machine Learning, 2023.
- Radford, A., Kim, J. W., Hallacy, C., Ramesh, A., Goh, G., Agarwal, S., Sastry, G., Askell, A., Mishkin, P., Clark, J., Krueger, G., and Sutskever, I. Learning Transferable Visual Models From Natural Language Supervision. International Conference on Machine Learning, 2021.
- Halgren, T. A. Merck Molecular Force Field. I. Basis, Form, Scope, Parameterization, and Performance of MMFF94. Journal of Computational Chemistry, 17(5–6):490–519, 1996.