引言
当我执笔开始写这篇笔记时, 我的心情是非常复杂的——甚至有些惊恐. 这里讨论的内容, 可能会对人类社会产生深远的影响, 甚至可能改变我们对未来的认知.
现在是北京时间 2026 年 9 月 14 日下午 4 点, 我一如既往地用我 vibe coding 的 DeepSeek-Harness 的 AI 日报插件爬取新闻资讯时, 一个提出了有一段时间, 但今天出现非常频繁的字眼出现在我眼前 —— 递归自我改进 (Recursive Self-Improvement, RSI).
新闻推送介绍到 Anthropic (同时也得到了 OpenAI 奥特曼支持), Google DeepMind , 甚至国内的智谱 都开始尝试让 AI 参与下一代 AI 的研发与训练. 尽管这些材料的证据强度并不完全相同, 也似有为商业计划造势之嫌, 但确实都已经具备 RSI 的部分闭环. 这还仅仅只是今天这一天的新闻, 先前还有 STOP 、Gödel Agent 、Darwin Gödel Machine 、A-Evolve-Training 等大量案例. 可以说, RSI 已经成为了今年 AI 研发的一个关键热词.
就我而言, 仅凭新闻现在的 RSI 就能看出好几层含义:
- Data-RSI: 模型生成、筛选和修正下一轮训练数据
- Harness-RSI: 自动修改 System Prompt、skill、工具、记忆和工作流
- Model-RSI: 直接训练或修改模型参数
- 更严格的 Meta-RSI: 连“采用什么改进策略”本身也会被下一轮系统改进
就在这些消息之后, 一篇标题略显危言耸听的综述出现了: [] Unknown-material . 这是来自上海交通大学、Theseus Labs、清华大学、字节跳动、上海人工智能实验室等机构的一篇 75 页综述, 在外网也引发了一些讨论. 9 月 10 日发在 ArXiv, 新鲜出炉.
这篇综述汇总了 491 篇相关工作, 收集了十几家大厂的 AI 研究成果, 贡献是提出一个非常实用的判断框架: 改进闭环中的哪些责任已经交给 AI, 哪些改变被下一轮继承, 以及谁仍然掌握最终判定权. 我们主要来讨论一下这篇.
为什么现在突然都在谈 RSI?
论文认为, 过去的 Scaling 不仅扩大参数和上下文, 也扩大了整个模型研发流程. 数据准备、训练、模型辅助实验、推理、评估和人工复核都在同时消耗资源. 它将压力概括为三类.
- 基模研发越来越重: 稀疏 MoE 可以减少每个 token 激活的参数量, 却不能消除专家路由、并行策略、长上下文、多模态和软硬件协同设计的复杂性. 数据质量与评测同样昂贵: 专家任务需要大量领域人员, 架构搜索还会让数据、优化器、模型和硬件形成组合爆炸.
- 训练反馈和学习环境也在 Scaling: 合成数据与强化学习把瓶颈从人对答案的生成移动到如何构造经验、判断经验并保留更新. 生成几百万条推理轨迹后需要确认它们正确、有区分度、恰好位于当前模型的学习边界, 而且不会把奖励模型的漏洞继续训练进去.
- 部署后还要反复适应: 真正的 Agent 面对持续变化的仓库、文档、网页、工具接口和组织工作流, 每次失败都可能要求人类重新诊断. RSI 的现实价值正是把这些反复发生的维护成本变成系统自身的持久能力.
现代基础模型中不均匀的能力进展
论文整理了 2023 年至 2026 年 9 月间、十个能力域上的 393 个可比较的“模型-基准”观测, 并提出 剩余空间闭合指数 (Headroom-Closed Index, HCI), 试图回答不同分数尺度的基准究竟消耗了多少提升空间.
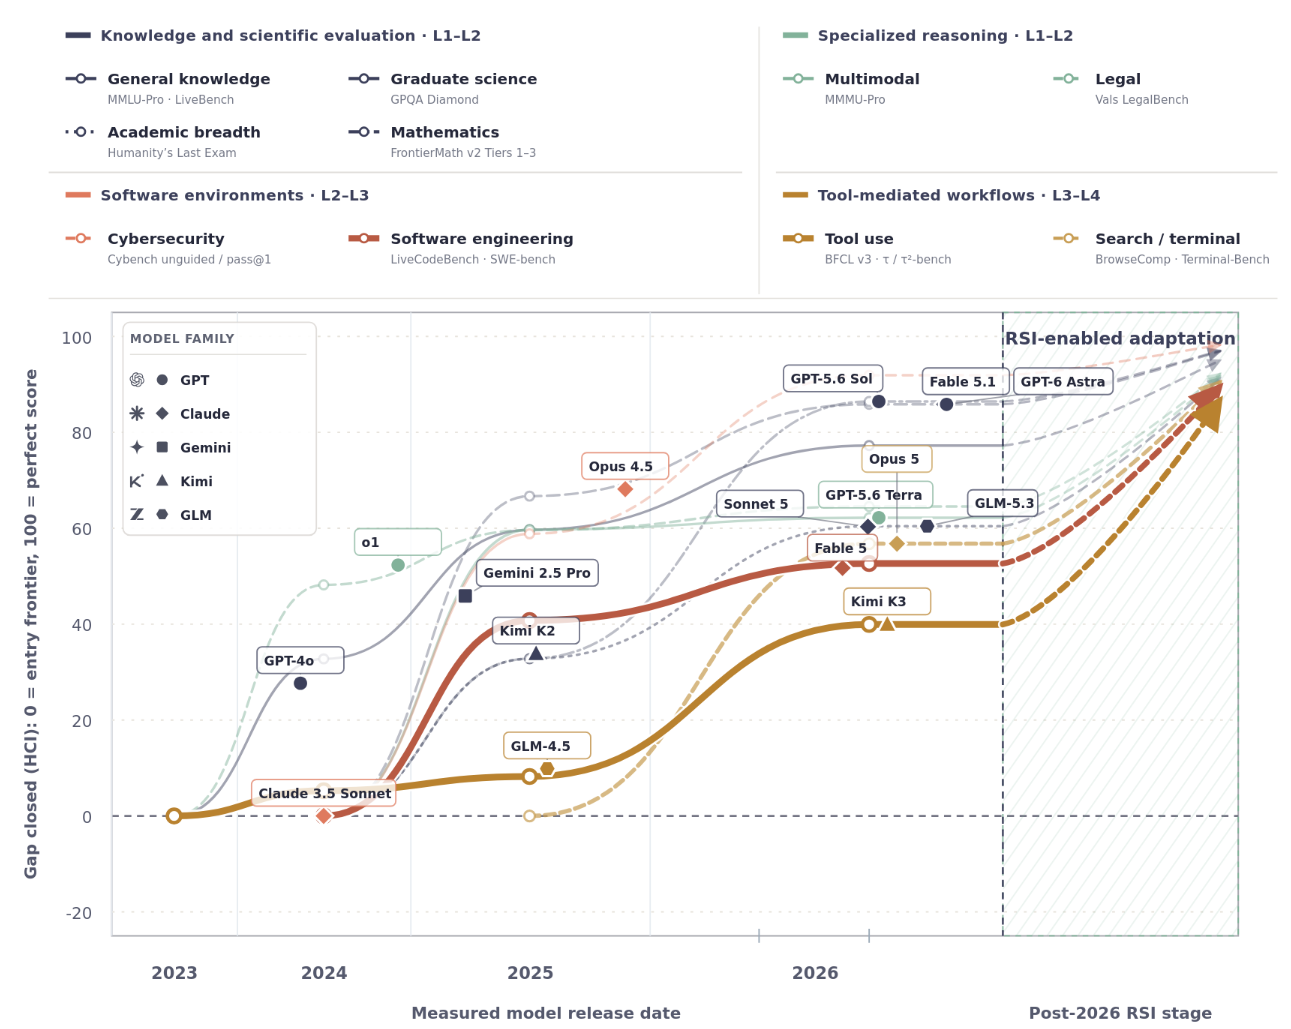
以某基准进入数据集第一年的前沿 $F_{b,0}$ 为零点:
$$ H_{mbh}=100\times\frac{\bar{s}_{mbh}-F_{b,0}}{100-F_{b,0}}. $$- $H=0$: 只达到这个基准刚进入统计时的前沿.
- $H=100$: 达到满分, 把当时剩余的 headroom 全部关闭.
- $H<0$: 低于入场年份的前沿.
从这个图中可以总结三个观察:
- 不同能力的进展幅度与时间形态不同: 高级数学与研究生科学相较于法律推理、多模态推理和前沿学术广度明显更高, 且存在着加速现象.
- 交互式能力仍保留更大的缺口: 搜索/终端 Agent 和 Tool Agent 仍然较低.论文认为, 有边界且容易验证的任务主要考验 L1-L2; 环境任务逐渐要求 L2-L3; 长程工作流还会暴露 L3-L4 所需的记忆、验证和适应能力. 这类任务必须同时完成规划、环境状态追踪、工具选择、结果解释和后续动作修正.
- 剩余 Headroom 集中了 RSI 的潜在价值: 论文认为, 持久且经过验证的 RSI 可能优先帮助当前缺口较大的部署工作流. 为了统一表达这个想法, 作者给出了图 3 中 RSI 示意区域的经验公式: $$ R_d-T_{d,2026}=0.78(100-T_{d,2026})$$即示意性地关闭每个领域剩余 headroom 的 $78\%$. 其含义是: 如果系统能反复生成经验、验证改动、保留更新并进行回归测试, 理论上可以将更多改进资源定向到薄弱的交互式工作流.
作者由此总结, 软件工程与工具使用尤其适合研究 RSI: 人类当前必须随着接口和仓库变化, 不断重建环境、收集轨迹、诊断失败、修改训练或 Harness 并进行回归测试; RSI 可以让系统从观察到的失败中生成练习, 把轨迹蒸馏为规则和工具, 再将通过测试的 Harness 或代码变化保留给未来任务.
递归自我改进的概念基础
改进闭环的九个部件
论文以 Improvement Loop 为基本分析单元.
- AI system: 被追踪能力状态的完整计算实体. 它包含采取行动、根据反馈生成修改、以及把结果带入下一轮的机制与持久状态.
- System state: 一轮结束后被保留、由下一轮继承的系统部分. 如果系统接受一段更快的程序并继续修改该版本, 这段程序就属于状态.
- Experience: 从先前交互中获得、会指导后续修改的信息. Test failure、环境结果或 Reviewer correction 只有在用于下一次更新时才成为经验.
- Target: 当前这一轮被直接修改的对象. 它可以是一段代码; 如果下一轮转而修改生成代码候选的方法, 那么搜索方法就成为新的 target.
- Improver: 将当前状态和已有经验转换为候选修改的机制. 例如读取现有代码与最近失败测试、再提出 patch 的模型.
- Strategy: Improver 决定去哪里搜索以及如何生成候选的方法. Strategy 本身可以被保留, 因而也可能成为下一轮的 target.
- Verifier: 评价候选并应用接受规则的机制. 信号可以来自 Benchmark、单元测试、Reward Model、环境结果、人类反馈、形式约束、安全检查或它们的组合.
- Improvement: 通过当前接受规则、被保留并进入下一系统状态的候选修改. 没有通过验证或没有继承的 proposal 不能算 improvement.
- Successor: 继承一项或多项已接受改进、以更新状态进入下一轮的 AI 系统.
这个解剖结构导出论文提出的三个问题:
- 闭环在哪里闭合? 决定了表面上的改进是否真的返回系统.
- 什么被更新并继承? 决定了哪些是持久改进.
- 哪些决定仍然在外部? 决定了哪些自我提升的权力可以从人类转接给 AI 自身.
RSI 的定义
在上述 Improvement Loop 基础上, 论文给出了如下定义 (这里直接翻译原文):
定义
递归自我改进 (Recursive Self-Improvement, RSI) 指的是智能系统通过与任务、环境或其他智能体持续交互, 自主地将获得的经验和反馈转化为跨交互轮次持久保留的自身变化, 例如模型参数、Agent Harness 或改进策略; 这些变化还能够继续影响后续自我改进的生成、评估、选择与固化机制. 已改进的系统以改变后的能力状态重新进入下一轮, 从而让“改进能力本身”成为持续递归过程的一部分.
RSI 与相邻范式的关系
如下几个概念跟 RSI 有明显的交叉:
- Continual Learning 从连续任务或数据中获取知识, 同时尽量减少旧能力遗忘. 它天然包含跨轮学习与持久保留, 但学习目标、更新规则、经验日程和验收测试通常由设计者固定. 当经验还能修改以后如何提出、评估或固化更新时, 它才接近 RSI.
- AutoML 自动处理数据、模型/架构选择、超参数和 Pipeline 构建. 即使 Agent 能自动完成整套 ML 实验, 搜索空间、目标、预算和 Evaluator 通常仍是预设的. 只有搜索或评估改进的程序成为持久状态, 并被下一轮继续改进, 它才接近 RSI.
- Agentic AI/ML 能规划多步任务、调用工具、执行实验、协调专门组件和修订中间产物. 但很多 Agent 只在一个 episode 内行动, Harness、工具、停止规则和接受标准不变. 经过验证的 Agent 更新跨任务保留并影响以后改进时, 它才接近 RSI.
论文用八个维度比较四种范式:
| 特征 | 含义 | CL | AutoML | Agentic | RSI |
|---|---|---|---|---|---|
| Cross-round learning (跨轮学习) | 第 $t$ 轮得到的信息是否会影响第 $t+1$ 轮. | ✓ | ◦ | ◦ | ✓ |
| Persistent retention (持久保留) | 一轮得到的权重、记忆、规则或代码是否在任务结束后仍被保存. | ✓ | ◦ | ◦ | ✓ |
| System self-modification (系统自修改) | 被改变的是 AI 系统自身, 而不是它正在处理的外部产物. | ✓ | ◦ | × | ✓ |
| Candidate proposal (候选改进生成) | 系统是否主动提出可能的架构、配置、Prompt、代码或策略变化. | × | ✓ | ✓ | ✓ |
| Update validation (更新验证) | 候选变化是否在接受前经过评估. | ◦ | ✓ | ◦ | ✓ |
| Successor re-entry (后继者重新进入闭环) | 被更新的系统是否作为 Successor 进入下一轮, 并从新状态继续学习或改进. | ✓ | × | × | ✓ |
| Mechanism revision (改进机制修改) | 产生或选择改进的方法本身是否会被改写, 例如搜索策略、更新程序或 Evaluator. | × | ◦ | × | ✓ |
| Mechanism reuse (改进机制复用) | 被改写的 Improver、Verifier 或研究策略是否会被后续轮次真正调用. | × | × | ◦ | ✓ |
其中 ✓ 表示该范式的主要核心目标, ◦ 表示可能发挥辅助作用但不是定义性目标, × 表示通常不在该范式处理范围内. 从这里也能看出, AI for AI 不等于 RSI.
从 B0 到 L5: 自治权逐层转移


始终记住如下三个问题: 闭环在哪里闭合? 什么被更新并继承? 哪些决定仍然在外部?
B0: 只停留于任务内
Self-Refine 的“生成-反馈-重写”、Reflexion 的任务内反思缓存、Tree of Thoughts 的候选思维搜索都属于典型 B0. 它们能显著改善当前答案, 但任务结束后不留下可供独立任务复用的系统变化.
论文给出了 B0 有四个根本限制:
- 经验只存在于临时上下文.
- 修改程序由人预先定义.
- 自生成的反馈可能强化错误.
- 没有新信息时反复迭代收益有限.
L1: 自主执行人类写好的改进 SOP
定义
L1 (改进执行自治) 的闭环是:
接收改进目标 $\rightarrow$ 执行预定的改进程序 $\rightarrow$ 产生改进 $\rightarrow$ 更新系统状态 $\rightarrow$ 使用新状态处理下一个任务 $\rightarrow$ 重复.
也就是说, 人类规定目标、更新程序和接受标准, AI 负责执行; 与 B0 不同, 通过验证的结果会成为持久状态并用于后续任务. 这么说来之前的 Test-Time Adaptation 应该就属于这一级.
论文沿完整 AI 研发栈列出六类例子:
- 数据层: FineWeb-Edu 按人类给定的教育质量规则打标签和过滤; SynthLLM 、SynthAgent 、Nemotron-4 按既定流程生成并筛选合成监督.
- 训练方法层: EDIT 诊断并只改写有问题的推理步骤, REPO 把标准操作程序的遵循程度转成奖励.
- 训练平台层: Agent-Agnostic C/C++ Optimization 按既定性能优化流程定位热点、改 C/C++ 并做正确性/性能回归; Meta NCCL Agentic Debugging 将 NCCL 超时诊断知识写成决策树和 Runbook 供 Agent 执行.
- 评估与安全层: HealthBench 由医学专家先写细粒度 rubric, 模型再大规模重复评分.
- 部署优化层: AIPC 按标准阶段完成模型转换、量化校准、兼容性修复和端侧验证.
- 应用系统层: AWS Agent Toolkit 、LinkedIn CAPT 与 OpenAI Harness Engineering 把组织经验编码成 skill、playbook 和工程约束, Agent 负责实施与测试.
L1 已经可以节省大量人力, 但它不会处理 SOP 没覆盖的新情形. 更危险的是, 输出已经会进入下游: 一次错误的数据过滤、训练修复或部署转换可能成为以后模型的输入.
Finding: L1
L1 在规模化场景中执行由人类定义的改进程序. 人类首先把已有工程经验编码成明确的改进步骤和验证规则, AI 系统再把这些预定义程序应用于具体任务. 产生的工件会被保留并纳入后续研发工作流, 使同一套改进程序能够在相互独立的任务和研发阶段中重复应用.
L2: AI 自身决定改进策略
定义
L2 (改进策略自治) 的闭环是:
观察系统表现 $\rightarrow$ 诊断失败或瓶颈 $\rightarrow$ 决定如何修改 $\rightarrow$ 实例化候选并测试 $\rightarrow$ 保留或回滚 $\rightarrow$ 重复.

也就是说, 人类仍然规定目标、任务边界和接受标准, AI 则从评估证据中自主选择下一项改进干预; 相比 L1, 新进入闭环的是决定改进策略.
论文按可编辑对象将它分为四类:
- Prompt Search: GEPA 从执行轨迹定位失败模块并产生针对性 Prompt 修改; Promptbreeder 、MPO 、C-Evolve 分别使用自指进化、多模态语义反馈和群体共识等机制.
- Agent/Harness Search: Microsoft Foundry Agent Optimizer 可重写 System Prompt、skill 与本地工具描述; ADAS 把 Agent 写成 Python forward function; AFlow 用 MCTS 搜索工作流图; AgentSquare 进化并重组 Agent 模块.
- 模型与训练搜索: AgentNAS 先生成任务特定的种子架构和搜索空间; AutoResearch 反复修改训练程序; NanoGPT 类环境让 Agent 自己诊断训练瓶颈、改代码和调配置.
- 系统实现搜索: AutoKernel 先 Profile 真正的端到端瓶颈, 再生成 Triton/CUDA 实现, 只有通过数值正确性检查并在真实 GPU 上加速的候选才保留.
这么一看, L2 很像自动研究实习生. 它最容易先发生在代码、Kernel 和训练流程中, 因为候选可执行、反馈和回滚都比较容易.
Finding: L2
L2 将人类的工作从“逐个提出改进”转移为“约束对改进的搜索”. 人类仍然规定目标和接受标准, 但不再需要亲自选择每一项候选干预. 瓶颈由执行一项已知改进, 转变为在可能的改进方案中进行搜索.
L3: AI 决定自己学习的内容
定义
L3 (学习信号或经验获取自治) 的闭环是:
观察 Learner 的当前状态 $\rightarrow$ 选择学习经验 $\rightarrow$ 获取经验 $\rightarrow$ 更新持久状态 $\rightarrow$ 用更新后的状态重塑未来经验 $\rightarrow$ 重复.

也就是说, 系统根据当前能力、失败和学习历史决定下一轮应该选择、生成或主动寻找什么经验; 学习后的系统状态又会改变之后的经验获取. 相比 L2, 新进入闭环的是决定接下来学什么.
自适应任务生成与 Self-Play
- SSP : 当前 Solver 的表现反过来塑造 Proposer 的奖励, 课程随学习者变化.
- Absolute Zero Reasoner (AZR) : 同一个模型提出并求解可执行推理任务, 用代码执行器验证, 用 learner-dependent learnability reward 寻找有学习价值的难度.
- R-Zero : Challenger 根据 Solver 多次回答的一致性估计不确定性, 为当前学习者出题.
- STP : Conjecturer 生成位于当前 Prover 能力边界附近的猜想, Proof Assistant 验证证明.
- PSV : 生成可编译 specification, 再形式化验证候选程序是否满足 specification.
在环境中自主练习
- Voyager : 根据 Minecraft 中的当前状态和探索历史选择新目标, 把成功行为固化为可执行 skill library.
- SIMA 2 : Task Setter 根据奖励模型对当前行为的评估, 把练习集中到薄弱技能.
- SEAgent : World State Model 分析 GUI 轨迹, Curriculum Generator 更新软件 guidebook 并产生后续练习任务.
L3 最重要的区分是有效、难、值得学, 这并不是一件事. 形式化验证只能说明答案满足当前 specification, 不保证题目有价值; 回答不一致可能意味着恰好位于学习边界, 也可能只是题目含糊; 一道困难且正确的题, 也未必会带来可迁移的学习增益.
有缺陷的经验或反馈会扭曲后续学习以及经验获取决策, 论文用 经验污染 (experience corruption) 来描述. 这是这种反馈闭环在结构上存在的风险.
Finding: L3
L3 增加了对未来学习议程的自治. 系统根据自身不断变化的能力、失败或学习历史, 决定下一步选择、生成或主动寻找什么经验; 持久学习的结果又会反馈到之后的经验获取决策中. 人类设计的目标、评估器和学习规则仍然可以保留; 经验自治只描述系统在这一框架内获得了哪些决策权, 本身并不保证经验有用或改进可靠.
L4: 从真实部署反馈中持续改变自身
定义
L4 (部署与环境适应自治) 的闭环是:
观察部署交互 $\rightarrow$ 提出持久适应方案 $\rightarrow$ 修改 Agent 组件 $\rightarrow$ 验证并保留 $\rightarrow$ 在后续任务中复用 $\rightarrow$ 收集新反馈并重复.
也就是说, 系统根据持续部署中的真实交互, 决定经验的哪些后果应该写入记忆、skill、工具、Harness、代码或模型参数, 并让这些变化影响后续行为与反馈. 相比 L3, 新进入闭环的是决定如何适应真实环境.
论文将 L4 的实现分为三组.
轨迹蒸馏
- 文本经验: Dynamic Cheatsheet 维护不断删改的策略笔记; ACE 为记忆条目记录帮助/伤害计数; ReasoningBank 从通过 Judge 标注的成功和失败轨迹中抽取简短策略.
- 结构化记忆: APEX 用里程碑依赖图记录已验证路径和未探索分支; PersonaAgent 、PAHF 维护用户画像或偏好; MemToolAgent 保存失败工具调用的 critique.
- 程序化 Skill: Trace2Skill 让成功分析器和失败分析器共同编辑可移植 skill 目录; PRACTICE 对 skill 做添加、合并、修改和删除; PANDO 在网页任务部署中积累防错规则和参数化 routine.
- 可执行工件: Metis 同时保存文本计划与代码工具. 某个计划被反复复用后才编译成函数, 并且必须在 Sandbox 通过运行检查.
轨迹蒸馏的价值在于把大量 episode 压缩为以后能被准确触发、成本更低的操作知识.
迭代修改 Agent 系统
- HarnessDev 从一个极小种子创建完整 Harness, 根据开发任务反复修改, 冻结候选后再用固定 Executor 在隐藏任务上比较成功率和 token 成本.
- ASPIRE 允许 Agent 自主选择数据、更新方法和验证信号, 但任何 verified score 没提高的改动都会回滚.
- DecoEvo 同时进化 Solver skill 与 rubric generator, 又用结构审计和对比审计避免 Judge 仅仅变宽松.
值得一提的是, 会写出好的 Harness 更新, 和 执行时会正确利用这个更新, 是两种不同能力. Harness Updating Is Not Harness Benefit 的分析发现, 小模型提出的更新可能不比前沿模型差; 真正的失败常出在执行者没有触发相关 skill, 或触发后没有忠实遵守.
选择性保留与上线
- HDSO 对候选 skill 做成对实验: 同一任务分别使用“现有库”和“现有库 + 候选”, 只有差异支持预先声明的假设, 再在独立任务确认后才准入.
- Library Drift 指出 skill 只增不减会逐渐破坏 Retrieval. 每条 skill 应带贡献证据, 低贡献项需要退休, 活跃库还要设容量上限; 但删除过激同样会变差.
- Tax AI 把从真实税务人员纠正中得到的失败聚类成评估目标, Coding Agent 修产品代码并跑针对性与回归测试, 最终仍以 Pull Request 交工程师复核上线.
L4 的典型问题叫 persistent update failure: 从噪声中学错结论、把正确规则用到错误范围、明明存了却没检索到、检索到了却没执行, 或新能力覆盖旧能力.
Finding: L4
L4 将自治范围从“选择经验”推进到“决定经验的哪些后果应在部署中持久保留”. Agent 把交互历史转化为对记忆、skill、Harness、代码或模型参数的持久修改, 这些修改会继续影响后续任务与反馈. 人类仍然掌握总体目标、受保护的接受标准、访问边界以及重大更新的最终发布权.
L5: 连“如何改进”也成为可继承对象
定义
L5 (递归继承或元改进自治) 的闭环是:
汇总先前尝试的证据 $\rightarrow$ 诊断改进过程的瓶颈 $\rightarrow$ 修订改进机制 $\rightarrow$ 独立验证并继承 $\rightarrow$ 由修订后的机制产生或选择后继者 $\rightarrow$ 用后继结果继续改进该机制.

也就是说, 系统不只修改任务 Agent, 还会持久修改负责未来改进的 Improver、Evaluator、Search Policy 或 Research Policy, 并让后继系统真正复用它. 相比 L4, 新进入闭环的是“改进如何发生”本身, 因而这是 Genuine RSI 的关键门槛.
可进化的 Meta 层主要有三类:
- Successor generation: 修改构造、训练和搜索后继者的方法.
- Candidate evaluation: 修改内部测试、Judge 与候选打分方法.
- Research control: 修改实验选择、研究方向和资源分配策略.
修改搜索过程
- STOP 把 Improver 本身写成一段会调用固定语言模型的 Python 程序. 当前 Improver 接收自己的源码, 生成后继 Improver, 后继者能否在下游任务中改出更好的程序评分.
- Gödel Agent 允许 AI 同时修改任务策略和递归更新逻辑. 修改后的程序在下一次递归调用中运行, 因而结构上很接近 L5.
- Darwin Gödel Machine (DGM) 保留多个 Coding Agent 变体和后代谱系, 但 Archive 维护和 parent selection 仍然固定.
- HyperAgents 进一步开放任务 Agent 和 Meta-Agent 的代码, 在跨任务测试中显示出一定的改进程序迁移.
修改后继者的评估器
固定 Judge 会被长期搜索逐渐榨干漏洞, 任意改变 Judge 又会让前后分数不可比. Red Queen Gödel Machine (RQGM) 的方案是一个 epoch 内冻结评估器, 到固定边界才让几个评估器竞争, 用独立 ground-truth anchor 验证替换者, 丢弃依赖旧评估器的分数, 必要时重新评估旧 Agent.
修改研究策略
A-Evolve-Training 在四轮 30B Nemotron 后训练中, 让 Worker 返回配方改变、Checkpoint 评测和失败记录, Collector 汇总, Meta-Agent 修改下一轮 Research Policy. 当开发分数提高却没有带来外部增益时, 新策略主动转向数据重平衡和 Checkpoint 选择.
Structural L5 不等于 Effective L5
这两个概念有非常重大的区别, 或许是整篇论文最值得记住的区分:
- Structural L5: 已证明一个由 AI 修改的 Improver、Verifier 或研究策略被保留, 并确实控制了下一轮.
- Effective L5: 还要证明修改后的机制在独立评估和相当总预算下, 能稳定地产生或选择更强的后继者.
当前工作最多证明了若干受限场景中的 Structural L5 和局部迁移. 例如 Weco AIDE2 能在 100 个无人值守步骤中接受七次 Research Harness 更新, 但把进化后的 Harness 安装为外层 Improver 时, 没有得到统计显著的效率优势. 系统能修改改进器, 与 它已经学会稳定地改进改进器, 中间还有很大距离.
更高等级不意味着更好
自治等级只表示 AI 掌握多少责任, 不表示收益、稳定性或安全性. 一个 L5 原型完全可能比精心设计的 L2 Pipeline 更差. 论文认为, 真正评价 L5 至少要看以下几个方面:
- Adaptivity: 多轮增益轨迹、到达目标所需时间、是否平台期.
- Retention: 旧任务是否被破坏, 重放时损失多少.
- Transfer: 更新任务之外、跨领域是否仍有增益.
- Efficiency: 每个经过验证的增益用了多少 token、时间、金钱和人工.
- Stability: 有害更新比例与最大临时退化.
- Meta-recursion: 修改机制是否在下一代被真正调用, 后继质量是否提高.
Finding: L5
L5 使改进程序本身成为可以继承的状态. 闭环通过重复使用修改后的 Improver、Evaluator 或 Research Policy 而闭合. 后继系统会继承该程序以及支持它的证据; 人类仍然掌握总体目标、受保护的接受标准和资源授权.

跨应用领域使用
同一个改进闭环放到不同领域, 最大差别在于 反馈能否便宜、准确、及时地支持继承. 这里就放一张表, 更细的不再赘述了.
| 应用域 | 可进化对象 | 反馈形态 | 论文判断的前沿 | 核心障碍 |
|---|---|---|---|---|
| S1: 科学发现 | 假设模块、实验 Agent、反思/改进器 | 模拟、实验、证伪、同行审查 | 强 L2, 早期 L3 | 实验昂贵, 失败难归因, 有效范围依赖假设 |
| S2: 具身智能 | 环境/课程、skill、policy、世界模型 | 模拟或物理交互 | L2-L3 为主, 模拟中出现 L4 | 经验由当前 policy 决定, 真实试验难复位且有风险 |
| S3: 软件工程 | Agent/Harness、经验库、团队结构、改进过程 | 编译、测试、Benchmark、真实仓库 | 成熟 L2、早期 L3、受限 Structural L5 | 测试不等于完整 specification, 跨仓库迁移困难 |
| S4: 医疗 | 临床记忆、推理策略、工具和工作流 | 医生纠正、指南、延迟临床结局 | 成熟 L2、有限 L3-like、模拟 L4 | 不允许自由试错, 结局混杂, 跨人群/机构外推危险 |
论文收集的产业实践
这一章的很多数据来自公司技术报告、工程博客、开源仓库和内部评估, 只用于展示真实 Pipeline, 不应与独立复现的同行评审实验混为一谈.
Theseus: Environment-Data-Model 共同进化
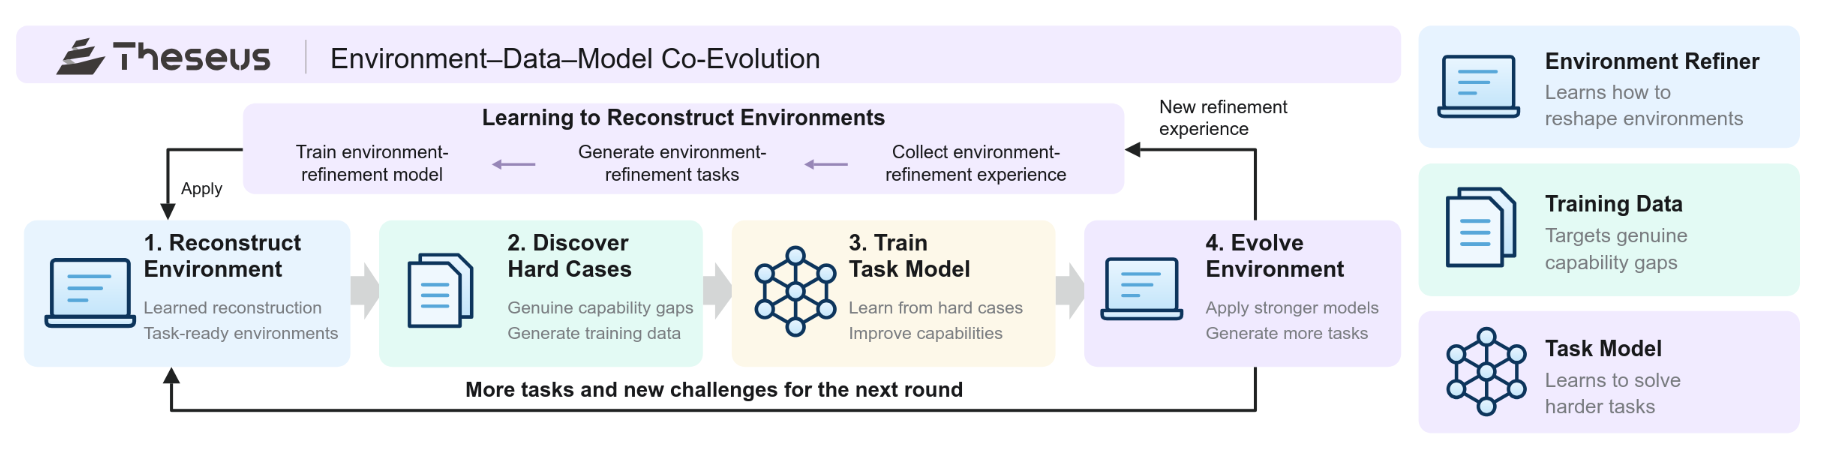
Theseus 的出发点是: Agent 的失败未必来自模型不够强, 也可能来自环境没有把知识、工具和验证条件组织好. 因而它不把环境视为固定 Benchmark, 而是把 环境、训练数据与任务模型 都放进可持续更新的状态.
其设计由两个互相咬合的循环组成. 上层循环收集环境整理过程中产生的 refinement experience, 将其转写成“如何重建工作空间”的训练任务, 再训练可复用的 Environment Refiner. 下层循环则真正推进能力:
- Reconstruct Environment: Environment Refiner 整理文件、依赖、时间线、工具入口和验证条件, 产出可执行、可追踪的任务环境;
- Discover Hard Cases: 固定当前任务模型在重建环境中工作, 将真实失败定位为当前能力缺口, 而不是笼统地收集更多数据;
- Train Task Model: 围绕这些缺口生成带验证信号的针对性数据, 更新任务模型;
- Evolve Environment: 更强的任务模型反过来参与更复杂的环境重建和任务生成, 同时留下新一轮 refinement experience.
这里真正被继承的不是一次任务答案, 而是重建后的环境、针对缺口的数据以及环境修复经验. 但它目前更像一个完整的 共同进化蓝图: 环境阶段已经启动, “环境改进 → 数据改进 → 模型改进 → 更强环境改进”的多轮复合闭环仍有待完整证明.
Lark: 建立可追溯的数据底座
飞书关注的是 RSI 经常被跳过的前提: 系统若没有持续更新且可归因的数据底座, 就无法判断自己究竟学到了什么. 它把企业协作中的文档、消息、会议和任务组织为带实体、事件、人员、权限和时间关系的知识图谱, 让跨来源查询不只是一次 RAG 检索, 而是建立在可追踪的上下文状态上.
完整数据飞轮分为五步:
- 从真实协作中持续收集异构数据和 Agent interaction trace;
- 抽取实体、事件和关系, 按时间组织知识图谱, 同时保留委托授权检查;
- 先用 absolute judgment 剔除明确不可用的结果, 再用 GSB (Good/Same/Bad) 成对比较判断候选版本是否优于当前版本;
- 将 bad case 归因到时间错乱、查询改写失真、来源质量差等具体环节, 形成修正后的数据与评价标准;
- 人工审核关键样本并决定版本晋升, 新版本在真实工作中产生的交互痕迹再返回下一轮.
因此, Lark 当前并不是自主修改模型的强 RSI, 而是一个 human-gated 的数据与评估闭环. 它的重要性在于让新鲜经验、质量判断和故障归因同时存在, 避免后续系统把数据漂移误认成能力提升.

Humanlaya: 当前批次修复与质量系统升级两层循环
Humanlaya 处理的是由任务描述、附件、参考答案、rubric 和验证要求共同组成的多文件数据包. 单个文件看似正确, 仍可能和任务说明或评分逻辑冲突, 所以系统把“修好当前样本”和“以后更会检查样本”明确拆成两层.
- 数据内环只修复当前批次. Task Package 依次经过检查内容及跨组件一致性的 Quality Checker、修复已确认问题的 Refiner、核对格式和交付约束的 Delivery Checker; 任一步失败都会触发定位、修改和复检. 这个循环改善的是工件, 本身仍属于 B0/L1.
- 改进外环跨批次更新质量系统. 系统汇总内部复核、客户反馈与下游使用证据, 将重复失败聚类为根因, 再让 Agent 提议带版本号的检查规则、Prompt、few-shot、Refiner instruction 或 skill 更新. 候选必须在未参与生成该更新的 held-out task package 上验证, 经人类审核批准后才替换旧版本.
它的关键设计是将 candidate update、隔离验证与版本晋升 分开: 当前样本的修复结果不能直接成为未来规则, 必须先证明其可泛化. 获准的新质量系统随后处理下一批任务, 新反馈又成为下一轮外环的输入, 因而构成带人类最终门控的 scaffold-level RSI.

ModelBest: 工程可能比开放式研究更早自治
ModelBest 判断工程问题可能比开放式研究更早实现高自治, 因为代码能执行、性能可测量、错误可复现、候选也容易回滚. Forge Engineering 以目标模型、硬件平台和并行要求为输入, 从空代码库开始构建可交付系统, 同样分为项目内外两层.
项目内层先读取包含 specification、评估标准、硬件约束、架构经验和参考实现的知识库, 据此确定高层结构并缩小搜索空间; 随后的 AutoResearch loop 反复生成实现、编译运行、测量正确性与性能、诊断瓶颈并修复. GEMM、FlashAttention 等局部优化只有通过数值正确性与端到端性能门槛后, 才逐步合入主执行路径.
项目外层负责跨场景继承. 一个场景结束后, 系统不会只保存最终代码, 而会把关键性能记录、有效优化策略、参考实现、失败模式和适用约束蒸馏回共享知识库. 下一个模型、硬件或工作负载再从这份更新后的状态开始. ForgeTrain 与 ForgeStencil 因而不仅是两个产物, 更是这套“稳定架构约束 + 激进底层搜索 + 经验证经验回写”范式在训练框架和科学计算 Kernel 上的两个实例.

Tencent Hunyuan Hyra: 保留可执行经验, 不只保留总结
Hyra (Hunyuan Research Agent) 刻意避免把搜索过程写成过于复杂的固定工作流, 而是让实验反馈持续塑造下一轮探索. 输入包括研究问题、工具与环境、评价标准、资源约束; 输出则不止是最佳答案, 还包括可以继承的代码、产物和研究知识.
每一轮中, Context Agent 从 Experience Bank 检索过去的解法、成功模式与失败案例, 重组出彼此不同的启发上下文; 多个 Proposal Agent 异步消费这些上下文, 并行提出候选. 每个候选都在新的隔离 Sandbox 中实现和执行, 评估器读取实际输出与日志后给分和反馈. 新产生的 solution code、artifact、execution log、score、evaluator feedback 与 failure case 全部写回 Bank, 因而后续 Agent 可以直接复用实现、组合不同路线或主动避开已知死路.
这比只保留自然语言总结更接近可执行继承. 更进一步, 当开放任务的 Judge 粒度不足或被搜索过程利用时, Hyra 允许利用累积经验加强比较基线、细化规则并封堵 reward hacking 漏洞, 然后让后续搜索在修改后的标准下继续. 这在结构上触及评估器演化的 L5 问题, 但仍需用独立 anchor 证明“更难骗”同时意味着“更可信”, 而不只是评价尺度发生漂移.

Agent-Native Research Lab: 给后继 Agent 留下可执行科研遗产
普通论文是面向人类交流的压缩格式, 往往删掉失败实验、精确配置、中间 trace 和可执行 specification; 对后继 Agent 而言, 这恰好是继续研究所需的操作状态. Agent-Native Research Artifact (ARA) 因而将研究遗产重新定义为四类共同保存的对象: 形式化科学逻辑、可执行代码与 specification、包含成功及废弃分支的探索图、原始经验与证据.
围绕 ARA 的循环依次执行 Research & Design → Execute → Curate & Learn → Verify & Select. Agent 先提出假设和计划, 再调用真实工具链执行; Curator 不只保留最佳路线, 也整理失败分支和其排除的假设. rit 协议把经验性 claim 锚定到 execution trace, 从日志重新提取报告中的数值; 分析性 claim 可交给 Lean 4 等形式系统检查. 只有通过这些确定性门的结论、代码和证据才能进入共享研究状态, 供后继模型继承.
系统还用 epistemic progress 补充稀疏的最终指标: 优先选择能够减少不确定性、揭示问题结构的实验, 避免只在熟悉参数附近爬坡. 硅设计是这种架构的一个适配场景: Agent 生成 SystemVerilog、测试平台和微架构修改, EDA 工具链负责综合、布局布线、时序分析和形式等价验证; 通过验证的设计及其完整谱系随后成为下一代的可执行起点.

通往 Genuine RSI 的八个障碍
在论文的最后, 作者提出了八个研究方向, 基本覆盖了一条 RSI Pipeline 从诊断到继承的所有薄弱点.
- 跨组件诊断与协同改进: 一个错误答案可能源于脏数据、缺上下文、工具接口、模型能力或 Judge. 系统应把通过组件冻结、针对性消融和依赖记录区分真正修复与对上游缺陷的补偿, 再在数据-模型-harness-环境之间分配搜索资源.
- Learner-conditioned 经验与可靠学习信号: 下一条经验必须同时考虑有效性、当前难度与边际学习价值. 当内部 Judge 不足时, 系统还要知道何时值得请求更昂贵的形式验证、真实实验或人类反馈, 同时评价自适应课程时应匹配总预算.
- 持久状态的管理与可靠复用: 每个记忆、skill 和工具都应记录支持证据、适用条件、依赖和实际贡献. 需要评价更新本身是否好、是否被正确检索、是否被忠实执行、是否最终有下游收益. 随模型和任务变化, 旧 artifact 还需要合并、重验、降级或退休.
- 面向领域反馈的受治理适应: 科学、机器人、软件和医疗需要不同验证强度. 可以用模拟、历史重放和沙箱做初筛, 再进入监督或分阶段真实评测. 软件无法撤回已经发生的机器人碰撞或临床伤害, 所以关键发布权、访问权限和安全约束必须明确留在受保护层.
- 可信地进化改进机制: Improver 与 Evaluator 一起变化会形成循环论证. 需要区分可编辑的内部反馈和独立维护的最终接受标准, 冻结 epoch 内 Judge, 用 ground-truth anchor 验证替换, 保留每次机制修改如何影响后续选择的证据, 并检测 Proposer-Judge 共同犯错.
- 长时间评估“继承的改进能力”: 应从相同初始 Agent 和证据出发, 匹配产生与评估 Improver 的总成本, 比较原始机制与新机制. 把进化机制冻结后放到新任务, 才能测到它是否学会了通用的改进策略.
- 资源感知与人机协作: Kernel 加速的同时还要考虑候选生成、验证、基础设施维护、专家 Review 和返工. 理想指标是到达一个验证能力目标所需的总时间、金钱、token 与人类工时. 系统也应学会基于预期学习价值和不确定性决定继续、暂停、升级给人或终止.
- 可复现的跨轮继承基础设施: 后继者不只需要最终结论, 还需要 parent state、候选改动、动机证据、环境和评估版本、接受决定、后续调用记录以及失败分支, 确保后续的可复现性.
重新审视一开始的新闻
以下观点来自 GPT, 并非我一家之见:
Anthropic
Anthropic 已干脆直接用 RSI 描述AI 加速 AI 研发的趋势, 并报告 Claude 在工程代码和自动研究中的参与不断上升 . 这些证据说明 L1 执行自动化和部分 L2 研究策略自动化正在扩大. 不过, 代码产出增加或研究吞吐提高只证明 AI R&D acceleration, 不能单独证明 L5.
Google DeepMind
Google 对 Gemini 3.8 的官方描述是使用长时间 Agent loop 递归评估并精炼底层模型 . 这至少表现出“实验结果回流模型改进”的 L2 结构; 如果练习任务由当前模型薄弱点决定, 还可能包含 L3. 这仍不足以确认网传的 rsi-model-liverl-le 已实现 RSI, 更不足以证明 Google 已跨过 L5.
智谱
智谱提出的 Fully Self Training 包含三部分: 模型自我对弈产生并交叉验证数据、Agent 自动生成和验证任务环境、模型参与推理基础设施优化; GLM-6.0 的长期方向被描述为“自进化” . 按论文框架映射:
- 自生成并过滤数据通常是 L1; 若任务难度由当前 learner 的缺口决定, 才升到 L3.
- 自动搜索训练/推理系统优化属于 L2.
- 自动构造随学习者共同变化的环境接近 L3, 进入持续真实部署反馈后才接近 L4.
- 只有训练策略、评估器或后继者生成程序也被修改并继承, 才触及 L5.
因此 Fully Self Training 是走向 RSI 的重要工程组合, 但从公开材料仍不能直接推导出“完全闭环的 Genuine RSI 已经实现”.
后记
回看一下, 标题 The Last AI Built by Humans 实际上表达的是一个目标状态: 如果人类制造出的某个 AI 能够自主设计、训练和验证自己的后继者, 并让更强的后继者继续改进这一过程, 那么它在修辞意义上可能成为“最后一个主要由人类亲手制造的 AI”. 论文明确认为我们还没有到达这里.
结合 AI 辅助, 写到这里时已经是当天晚上 12 点了. GPT 始终认为这篇论文并没有证明智能爆炸已经到来, 甚至在尝试开导我的担忧.
它说的没错, 这篇文章其实只是为可能到来的变化给出了一套测定体系: 真正关键的进步, 正是经过验证并被继承的改变, 让下一轮更善于获取经验、寻找改法、验证后继者, 并在明确的资源与权力边界内持续重复这一过程.
GPT 甚至犀利地断言, 这篇文章会老化得非常快. 它的优势恰恰是“新鲜”, 但 Agent、Harness 和自动研究系统几个月就可能换一代, 不过在它看来这是一个“非常优秀”的 RSI 领域地图, 这么高的评价在 GPT 中可不多见.
且不论文章质量, 所谓的 L5 时刻还有多远呢? GPT6-Astra 已经让我瘫坐眩晕了, 但它可能仍然只是 L2-L3. 也许正如标题所说, 完全属于人类的自己的最后一个 AI, 可能不久就要到来了.
参考文献
- When AI builds itself: Our progress toward recursive self-improvement, and its implications, 2026. https://www.anthropic.com/institute/recursive-self-improvement
- We Must Pace the Frontier, 2026. https://darioamodei.com/post/we-must-pace-the-frontier
- Introducing Gemini 3.8 Flash and 3.8 Flash Cyber, Google, 2026. https://blog.google/innovation-and-ai/models-and-research/gemini-models/3-8-flash-and-3-8-flash-cyber/
- Sergey Brin is cooking up Google's AI destiny, Business Insider, 2026. https://www.businessinsider.com/sergey-brin-google-gemini-ai-microkitchen-2026-9
- 智谱回应“只会后训练”质疑:下一代基座模型已在推进, GLM-6.0 瞄准“自进化”, 每日经济新闻, 2026. https://www.nbd.com.cn/articles/2026-09-01/4568516.html
- Madaan, A., Tandon, N., Gupta, P., Hallinan, S., Gao, L., Wiegreffe, S., Alon, U., Dziri, N., Prabhumoye, S., Yang, Y., et al. Self-Refine: Iterative Refinement with Self-Feedback. Advances in Neural Information Processing Systems, 36:46534–46594, 2023.
- Shinn, N., Cassano, F., Berman, E., Gopinath, A., Narasimhan, K., and Yao, S. Reflexion: Language Agents with Verbal Reinforcement Learning. arXiv:2303.11366, 2023.
- Yao, S., Yu, D., Zhao, J., Shafran, I., Griffiths, T., Cao, Y., and Narasimhan, K. Tree of Thoughts: Deliberate Problem Solving with Large Language Models. Advances in Neural Information Processing Systems, 2023.
- Penedo, G., Kydlíček, H., Allal, L. B., Lozhkov, A., Mitchell, M., Raffel, C., von Werra, L., and Wolf, T. The FineWeb Datasets: Decanting the Web for the Finest Text Data at Scale. Advances in Neural Information Processing Systems, 37:30811–30849, 2024.
- Microsoft Research. SynthLLM: Breaking the AI Data Wall with Scalable Synthetic Data. Microsoft Research, 2025. https://www.microsoft.com/en-us/research/articles/synthllm-breaking-the-ai-data-wall-with-scalable-synthetic-data/
- Wang, Z., Liang, Y., Zhang, X., Wu, Q., Han, S., Bastos, A., Wang, R., Bansal, C., Peng, B., Gao, J., Rajmohan, S., and Yao, H. SynthAgent: Adapting Web Agents with Synthetic Supervision. Proceedings of ACL, pp. 15730–15752, 2026.
- NVIDIA. Nemotron-4 340B Technical Report. arXiv:2406.11704, 2024.
- Wu, Z., Zhang, L., Wang, T., Zhao, R., Andrews, P., Aloisi, C., and He, Y. EDIT: Evidence-Diagnosed Intervention Training for Rule-Faithful LLM Grading. arXiv:2606.06350, 2026.
- Zeng, X., Chen, Y., Liu, L., Luo, C., Chen, Y., and Zhuangzhuoran. Teaching LLM to Be Persuasive: Reward-Enhanced Policy Optimization for Alignment from Heterogeneous Rewards. Proceedings of ACL Industry Track, 2026.
- Lu, H. and Xia, C. Agent-Agnostic End-to-End C/C++ Application Performance Optimization. Proceedings of the International Conference on Supercomputing Workshops, pp. 65–69, 2026.
- Liu, P., Wu, J., and Thakore, U. Leveraging Agents to Debug NCCL Watchdog Timeouts: A Technical, Repeatable Workflow. @Scale: Systems & Reliability, 2026.
- Arora, R. K., Wei, J., Soskin Hicks, R., Bowman, P., Quiñonero-Candela, J., Tsimpourlas, F., Sharman, M., Shah, M., Vallone, A., Beutel, A., Heidecke, J., and Singhal, K. HealthBench: Evaluating Large Language Models Towards Improved Human Health. arXiv:2505.08775, 2025.
- Su, J., Wu, Z., Huang, S., and Feng, W. AIPC: Agent-Based Automation for AI Model Deployment with Qualcomm AI Runtime. arXiv:2604.14661, 2026.
- Amazon Web Services. Agent Toolkit for AWS. 2026. https://aws.amazon.com/products/developer-tools/agent-toolkit-for-aws/
- LinkedIn Engineering. Contextual Agent Playbooks and Tools: How LinkedIn Gave AI Coding Agents Organizational Context. LinkedIn Engineering Blog, 2026.
- OpenAI. Harness Engineering: Leveraging Codex in an Agent-First World. 2026. https://openai.com/index/harness-engineering/
- Agrawal, L. A., Tan, S., Soylu, D., Ziems, N., Khare, R., Opsahl-Ong, K., Singhvi, A., Shandilya, H., Ryan, M. J., Jiang, M., et al. GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning. International Conference on Learning Representations, 2026.
- Fernando, C., Banarse, D., Michalewski, H., Osindero, S., and Rocktäschel, T. Promptbreeder: Self-Referential Self-Improvement via Prompt Evolution. Proceedings of the 41st International Conference on Machine Learning, 2024.
- Choi, Y., Kim, D., Baek, J., and Hwang, S. J. Multimodal Prompt Optimization: Why Not Leverage Multiple Modalities for MLLMs. arXiv:2510.09201, 2026.
- Li, T., Wang, Y., Chen, Z., Wang, Z., Ma, L., and Qi, G.-J. C-Evolve: Consensus-Based Evolution for Prompt Groups. International Conference on Learning Representations, 2026.
- Quintanilla, L. and Dibia, V. Introducing Agent Optimizer in Foundry Agent Service. Microsoft Foundry Blog, 2026. https://devblogs.microsoft.com/foundry/agent-optimizer-build2026/
- Hu, S., Lu, C., and Clune, J. Automated Design of Agentic Systems. International Conference on Learning Representations, 2025.
- Zhang, J., Xiang, J., Yu, Z., Teng, F., Chen, X.-H., Chen, J., Zhuge, M., Cheng, X., Hong, S., Wang, J., Zheng, B., Liu, B., Luo, Y., and Wu, C. AFlow: Automating Agentic Workflow Generation. International Conference on Learning Representations, 2025.
- Shang, Y., Li, Y., Zhao, K., Ma, L., Liu, J., Xu, F., and Li, Y. AgentSquare: Automatic LLM Agent Search in Modular Design Space. International Conference on Learning Representations, 2025.
- Jeong, S., Kim, M., and Kim, T. Agentic Neural Architecture Search. arXiv:2607.07984, 2026.
- Karpathy, A. autoresearch: AI Agents Running Research on Single-GPU NanoChat Training Automatically. GitHub repository, 2026. https://github.com/karpathy/autoresearch
- Jaber, J. and Jaber, O. AutoKernel: Autonomous GPU Kernel Optimization via Iterative Agent-Driven Search. arXiv:2603.21331, 2026.
- Lu, H., Wen, Y., Cheng, P., Ding, R., Guo, J., Xu, H., Wang, C., Chen, H., Jiang, X., and Jiang, G. Search Self-Play: Pushing the Frontier of Agent Capability without Supervision. International Conference on Learning Representations, 2026.
- Zhao, A., Wu, Y., Wu, T., Xu, Q., Yue, Y., Lin, M., Wang, S., Wu, Q., Zheng, Z., and Huang, G. Absolute Zero: Reinforced Self-Play Reasoning with Zero Data. Advances in Neural Information Processing Systems, 2025.
- Huang, C., Yu, W., Wang, X., Zhang, H., Li, Z., Li, R., Huang, J., Mi, H., and Yu, D. R-Zero: Self-Evolving Reasoning LLM from Zero Data. International Conference on Learning Representations, 2026.
- Dong, K. and Ma, T. STP: Self-Play LLM Theorem Provers with Iterative Conjecturing and Proving. Proceedings of the 42nd International Conference on Machine Learning, 2025.
- Wilf, A., Aggarwal, P., Parno, B., Fried, D., Morency, L.-P., Liang, P. P., and Welleck, S. Propose, Solve, Verify: Self-Play through Formal Verification. Proceedings of the 43rd International Conference on Machine Learning, 2026.
- Wang, G., Xie, Y., Jiang, Y., Mandlekar, A., Xiao, C., Zhu, Y., Fan, L., and Anandkumar, A. Voyager: An Open-Ended Embodied Agent with Large Language Models. arXiv:2305.16291, 2023.
- SIMA Team, Bolton, A., Lerchner, A., Cordell, A., Moufarek, A., Bolt, A., et al. SIMA 2: A Generalist Embodied Agent for Virtual Worlds. arXiv:2512.04797, 2025.
- Sun, Z., Liu, Z., Zang, Y., Cao, Y., Dong, X., Wu, T., Lin, D., and Wang, J. SEAgent: Self-Evolving Computer Use Agent with Autonomous Learning from Experience. Proceedings of the 43rd International Conference on Machine Learning, 2026.
- Suzgun, M., Yuksekgonul, M., Bianchi, F., Jurafsky, D., and Zou, J. Dynamic Cheatsheet: Test-Time Learning with Adaptive Memory. Proceedings of EACL, pp. 7080–7106, 2026.
- Zhang, Q., Hu, C., Upasani, S., Ma, B., Hong, F., Kamanuru, V., Rainton, J., Wu, C., Ji, M., Li, H., et al. Agentic Context Engineering: Evolving Contexts for Self-Improving Language Models. International Conference on Learning Representations, 2026.
- Ouyang, S., Yan, J., Hsu, I., Chen, Y., Jiang, K., Wang, Z., Han, R., Le, L., Daruki, S., Tang, X., et al. ReasoningBank: Scaling Agent Self-Evolving with Reasoning Memory. International Conference on Learning Representations, 2026.
- Li, Y., Yang, J., Zheng, Z., Hu, Z., Sui, Y., Wang, S., He, Y., and Hooi, B. APEX: Autonomous Policy Exploration for Self-Evolving LLM Agents. arXiv:2605.21240, 2026.
- Zhang, W., Zhang, X., Zhang, C., Yang, L., Shang, J., Wei, Z., Zou, H. P., Huang, Z., Wang, Z., Gao, Y., et al. PersonaAgent: Bridging Memory and Action for Personalized LLM Agents. Findings of ACL, pp. 26421–26439, 2026.
- Liang, K., Kruk, J., Qian, S., Yang, X., Bi, S., Yao, Y., Nie, S., Zhang, M., Liu, L., Fisac, J. F., et al. Learning Personalized Agents from Human Feedback. arXiv:2602.16173, 2026.
- Er, S. A., Ribeiro, D., Virkar, Y., Lakew, S., Kalyanpur, A., Gung, J., Delteil, T., and Gupta, A. MemToolAgent: Leveraging Memory for Tool Using Agents Based on Environment and User Feedback. arXiv:2606.07909, 2026.
- Ni, J., Liu, Y., Liu, X., Sun, Y., Zhou, M., Cheng, P., Wang, D., Zhao, E., Jiang, X., and Jiang, G. Trace2Skill: Distill Trajectory-Local Lessons into Transferable Agent Skills. arXiv:2603.25158, 2026.
- Bai, Z., Li, S., Huang, T., and Karlsson, B. F. PRACTICE: From Experience to Expertise in Self-Evolving Embodied Agents. arXiv:2608.30760, 2026.
- Li, Y., Miao, Y., Shen, Y., and Liu, Y. PANDO: Efficient Multimodal AI Agents via Online Skill Distillation. arXiv:2605.24785, 2026.
- Dai, Z., He, S., Li, H., Zhou, Q., Li, J., Song, M., Long, G., Si, H., Yao, X., Zhang, L., et al. Metis: Bridging Text and Code Memory for Self-Evolving Agents. arXiv:2606.24151, 2026.
- Wu, Y., Zhang, J., Shi, J., Zhang, Y., Lei, X., Zhou, J., Wang, Z., Wu, Y., Zhou, H., Wang, D., et al. ASPIRE: Can Models Self-Evolve from Vague Goals? arXiv:2608.31111, 2026.
- Wu, Y., Zhang, J., Shi, J., Lei, X., Gu, Q., Zhang, Y., Wang, Z., He, C., Huang, C., Song, M., et al. HarnessDev: Can LLMs Create and Evolve Their Own Agent Harness? arXiv:2609.01437, 2026.
- Chen, J., Song, Z., Liu, J., Zhou, S., Wu, H., Shi, H., Zhou, C., Li, H., Yang, X., Zhu, D., et al. DecoEvo: Score-Decoupled Co-Evolution of Solver and Rubric-Generator Skills in Text Space. arXiv:2607.25675, 2026.
- Shang, F. and Yang, Y. Hypothesis-Driven Skill Optimization for LLM Agents. arXiv:2606.22330, 2026.
- Zhang, X., Cui, Y., Wang, G., Li, Z., Qiu, W., Zhu, B., and He, P. Library Drift: Diagnosing and Fixing a Silent Failure Mode in Self-Evolving LLM Skill Libraries. arXiv:2605.19576, 2026.
- Lin, M., Wu, J., Wang, Z., Shi, Z., Sang, Y., He, B., Liu, Z., Wei, T., Wu, Z., Zhang, Z., et al. Harness Updating Is Not Harness Benefit: Disentangling Evolution Capabilities in Self-Evolving LLM Agents. arXiv:2605.30621, 2026.
- OpenAI and Thrive Holdings. Building Self-Improving Tax Agents with Codex. Engineering case study, 2026. https://openai.com/index/building-self-improving-tax-agents-with-codex/
- Zelikman, E., Lorch, E., Mackey, L., and Kalai, A. T. Self-Taught Optimizer (STOP): Recursively Self-Improving Code Generation. Conference on Language Modeling, 2024.
- Yin, X., Wang, X., Pan, L., Lin, L., Wan, X., and Wang, W. Y. Gödel Agent: A Self-Referential Agent Framework for Recursive Self-Improvement. Proceedings of ACL, 2025.
- Zhang, J., Hu, S., Lu, C., Lange, R., and Clune, J. Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents. International Conference on Learning Representations, 2026.
- Zhang, J., Zhao, B., Yang, W., Foerster, J., Clune, J., Jiang, M., Devlin, S., and Shavrina, T. HyperAgents. arXiv:2603.19461, 2026.
- Iacob, A., Jovanović, A., Shen, W. F., Burkhardt, D., Kurmanji, M., Tastan, N., Sani, L., Venanzi, N. A. E., Odonnat, A., Cao, Z., et al. The Red Queen Gödel Machine: Co-Evolving Agents and Their Evaluators. arXiv:2606.26294, 2026.
- Shi, Z., He, B., Sang, Y., Lu, H., and Dumoulin, B. A-Evolve-Training: Autonomous Post-Training of a 30B Model. arXiv:2606.20657, 2026.
- Weco Team. AIDE2: The First Evidence of Recursive Self-Improvement. Weco AI Blog, 2026. https://www.weco.ai/blog/first-evidence-of-recursive-self-improvement
- Zhu, Z., He, Q., Li, S., Chen, Y., Sun, H., Li, Z., Li, Y., and Liu, Z. ForgeTrain: Forging Production-Grade Training Frameworks via Harness-Driven AI Development. Technical report and GitHub repository, 2026. https://github.com/OpenBMB/ForgeTrain
- The ForgeStencil Authors. ForgeStencil: Autonomous Agents for Stencil Optimization and Deployment. GitHub repository, 2026. https://github.com/OpenBMB/ForgeStencil
- Tencent Hunyuan. Hyra (Hunyuan Research Agent): Research Artifacts. GitHub repository, 2026. https://github.com/Tencent-Hunyuan/Hyra-results
- Duan, Y., Liu, Y., Tang, Z., Chen, H., Zhou, J., Liu, Y., Xu, B., Wu, Y., Chen, S., Zhou, Y., et al. Tencent Hunyuan: Experience-Driven Self-Improvement. Section 5.5 in The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement, 2026. https://arxiv.org/html/2609.11873v1#S5.SS5